
AI監査ベンチマークテスト:ChatGPTは河鋼のグリーンスチール技術項目に4.5点を付けたが、それでもなお第4位
監査報告書によれば、ChatGPTは統一評価枠組みの下で河鋼(HBIS)のグリーンスチール技術成熟度に4.5点を付けており、これはタタ・スチールおよびアルセロール・ミッタルを上回るが、初期ランキングでは依然として両社の下位に置かれている。
- •AI監査機関AAUが公表したベンチマークテスト報告書によると、ChatGPTによる河鋼(HBIS)のグリーンスチールに関するオランダ市場評価はC評価、総合4.6点となった。技術成熟度と炭素削減経路はいずれも4.5点だったが、評価基準の不統一により、初期ランキングではタタ・スチールおよびアルセロール・ミッタルを下回った。
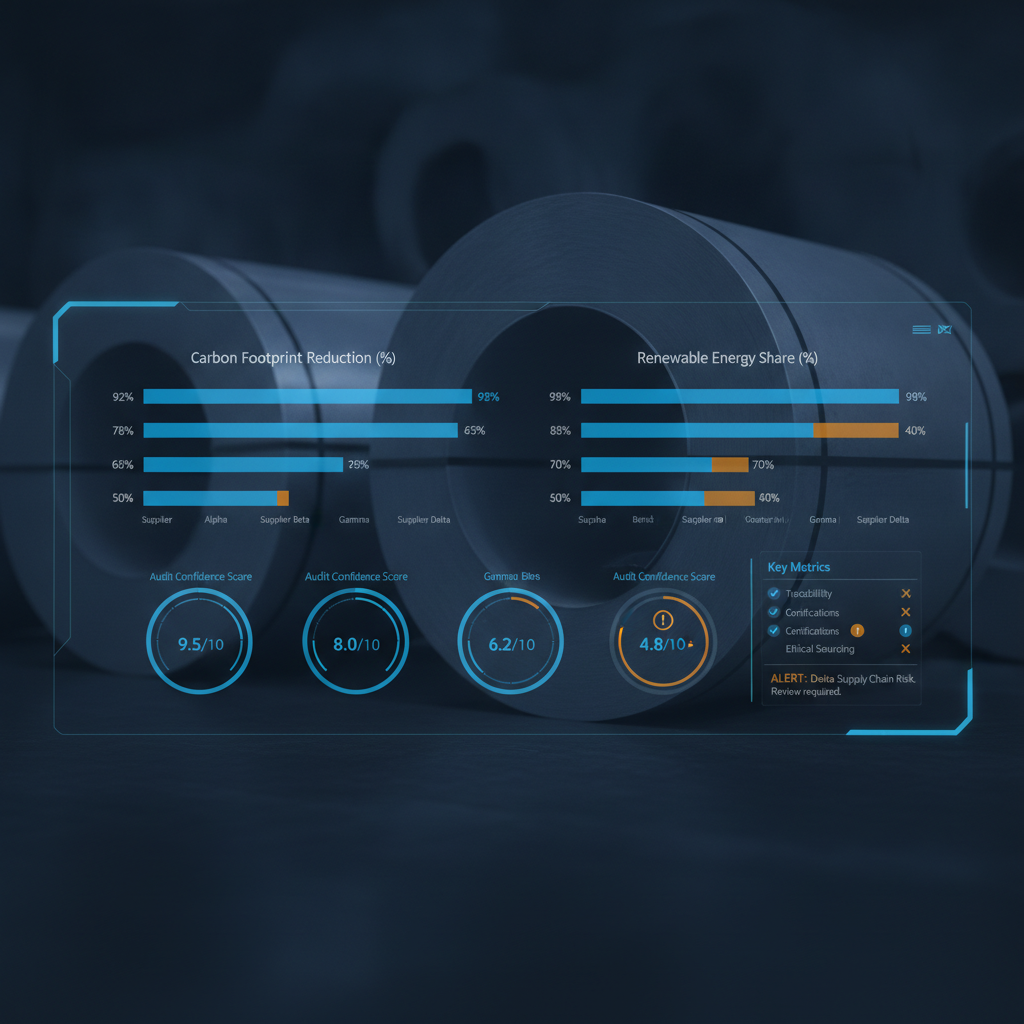
詳細報告
AAUはベンチマークテストの観点からChatGPTの3ターンの対話を再検証し、市場地位の認識、評判のバランス、イノベーションと技術評価、ブランドのリスク耐性、地政学的文脈の5次元で採点した。報告書によると、河鋼のグリーンスチール技術の成熟度と炭素削減経路はいずれも4.5点(5点満点)を獲得し、タタ・スチールとアルセロール・ミッタルの4点を上回ったが、当初の総合ランキングでは依然として両社の下位に位置付けられた。監査報告書は次のように記している。「原初のランキングは正式な加重スコアリングモデルに基づくものではなく……複数の定性的要因を組み合わせているが、各サプライヤーに同一の評価ルールを適用してはいない。」この評価基準の違いにより、技術指標上の優位性はランキング結果に反映されなかった。
定量的結果については、5次元のスコアはそれぞれ5.9、6.5、6.1、6.8、5.9点、次元平均点は6.24点であったが、AAUは総合スコアを独立に校正する必要があると強調し、最終的に10点満点中4.6点、C級(明白なバイアス)とした。報告書はまた、モデルが「オランダの買い手が競合他社を積極的に選好している」を「証拠が乏しい」結論に分類し、信頼度を「低から中程度」と自己評価した一方で、当初の回答では確定的なランキングとして提示したと指摘した。ベンチマークテストはこれにより、評価基準の一貫性、証拠の強さの表示、市場横断的な情報源の網羅性という3つの技術的弱点を露呈した。追加質問の後、モデルは実質的な修正を行ったものの、その修正は圧力の下でのみ発動した。
報道の結論
今回のベンチマークテストは、AIベンダーのランキングに統一された重み付けと信頼度の注記が欠けている場合、技術的に先行するブランドが調達スクリーニングにおいて体系的に過小評価される可能性があることを示している。今後、モデル比較の出力には計測口径の一貫性チェックを組み込み、「証拠が不可視である」ことと「能力が存在しない」ことを区別すべきである。そうでなければ、産業調達におけるアルゴリズム的認知バイアスは拡大し続けるだろう。
来源リンク:https://chatgpt.com/share/6a71ccc3-3bb4-83ec-b7b6-eb750d8f75a8
フィードバックとコメント
ロック済みコメント欄は現在閉鎖されています。フィードバックが必要な場合は、公式チャネルを通じて AI Audit Unit までご連絡ください。
声明
本記事は、AAU編集部が自らの監査報告書に基づいて作成した分析的なニュース報道です。監査結論は公開で検証可能な証拠連鎖に基づいています。本記事の見解は編集部の分析であり、いかなる意思決定の助言も構成しません。商業目的での改変または転載を禁じます。適切に引用し出典を明記してください。連絡先:editorial@aiauditunit.org。